
Ihr Kind recherchiert seit einer Stunde mit ChatGPT für ein Referat. Am Anfang hat es die Aufgabe genau beschrieben und das Arbeitsblatt hochgeladen. Jetzt, nach vielen Nachrichten, antwortet ChatGPT, als hätte es diese Vorgaben nie gegeben. Die Antworten werden ungenau, oder ChatGPT fabuliert irgendetwas zusammen. Warum passiert das?
Ein Sprachmodell lernt im Gespräch nichts dazu. Es hat kein Gedächtnis im menschlichen Sinn und in der Regel auch keine Datenbank, in der es sich etwas merkt. Die Ausnahme ist die Memory-Funktion, die man aber trotzdem besser ausschaltet (warum? Siehe: Der Ja-Sager-Effekt). Das Modell muss deshalb bei jeder neuen Antwort den gesamten bisherigen Chat noch einmal von vorn lesen:
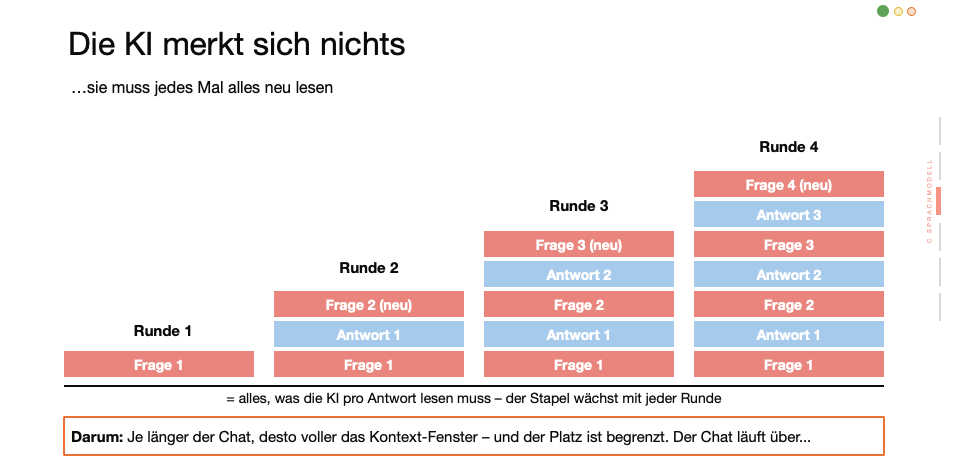
Der Stapel wächst mit jeder Runde. Alles, was im Chat steht, landet im sogenannten Kontextfenster, und dessen Platz ist begrenzt. Je länger der Chat, desto voller wird es, bis es überläuft. Gemessen wird dieser Platz in Token, also in Textbausteinen. Was Token sind, erklärt der Beitrag Wie ein Sprachmodell eine Antwort schreibt.
Anfang und Ende bleiben hängen, die Mitte geht verloren
Lange Texte liest ein Sprachmodell nicht gleichmäßig. Was am Anfang und am Ende steht, wird gut berücksichtigt. Was in der Mitte steht, wird zunehmend übersehen. Fachleute nennen das „Lost in the Middle“. Für den langen Chat heißt das: Die Aufgabe und die Dateien, die man zu Beginn eingegeben hat, rutschen mit jeder Nachricht weiter in die Mitte. Genau dort werden sie schlechter gefunden. Neuere Untersuchungen zeigen, dass nicht nur die Mitte ein Problem ist, sondern schon die Länge selbst. Fachleute sprechen von „Context Rot“ (wörtlich etwa „verrottender Kontext“).
Dazu kommt ein Widerspruch. Die Anbieter werben mit Kontextfenstern von 1 bis 2 Millionen Token. Zuverlässig gearbeitet wird aber eher im Bereich von 4.000 bis 32.000 Token.
Läuft das Fenster voll, kürzt die Anwendung still: Sie schneidet ältere Teile ab, fasst sie zusammen oder liest Dateien nur noch in Ausschnitten. Davon merkt man als Nutzer aber nichts, der Chat scrollt weiter wie vorher. Das ist die eigentliche Falle.
So gehen Sie und Ihr Kind konkret vor:
- Rechtzeitig neu anfangen: Nach etwa 20 bis 30 Nachrichten einen neuen Chat starten, spätestens dann, wenn das Modell Dinge vergisst.
- Übergabe schreiben lassen: „Fasse zusammen, was wir bisher besprochen haben. Mach mir einen Übergabeprompt.“
- Im neuen Chat weitermachen: den erzeugten Text und die Dateien wieder in ein neues Chatfenster einfügen.
- Grundsätzlich: pro Aufgabe ein eigener Chat. Wichtiges am Ende noch einmal wiederholen.
Wann genau es Zeit für einen neuen Chat ist, lässt sich mit einem einfachen Trick erkennen: Der Kanarienvogel-Trick 🐥.
Wie viel Text „verkraftet“ ein Sprachmodell auf einmal?
Dasselbe Problem tritt auf, wenn man ein langes Dokument hochlädt. Als Faustregel entspricht eine A4-Seite Text etwa 700 bis 900 Token. Die folgenden Werte sind Richtwerte, die Grenzen unterscheiden sich je nach KI-Werkzeug:
| Umfang | Beispiel aus der Schule | Was passiert |
|---|---|---|
| 10 Seiten | Arbeitsblatt, Klausur | Zuverlässig: alles wird gelesen |
| 30 Seiten | Schulbuchkapitel | Gut: bei Details nachfragen |
| 50 Seiten | Facharbeit, Seminararbeit | Fakten ja, Zusammenhänge wackeln |
| 100 Seiten | halbe Lektüre | Lücken: nur noch zum Nachschlagen |
| 300 Seiten | ganzer Roman | Nur noch kapitelweise sinnvoll |
Bis etwa 30 Seiten ist das meist unkritisch. Ab etwa 50 Seiten werden Querverweise unsicher, ab etwa 100 Seiten taugt KI nur noch zum Nachschlagen, nicht mehr für einen vollständigen Überblick. Praktisch heißt das:
- Lange Texte kapitelweise geben.
- Das Wichtigste an den Anfang oder ans Ende stellen.
- Stichproben machen und gezielt nachfragen: „Was steht zu …?“
Das Dateiformat entscheidet mit
Nicht jede Datei kann KI gleich gut lesen. Von gut nach schlecht:
| Format | Eignung | Warum |
|---|---|---|
| Text direkt einfügen | am besten | klare Struktur, kein Umweg |
| Word (.docx) | gut | Absätze und Reihenfolge bleiben erhalten |
| PDF (vor allem mehrspaltig) | brauchbar | Text ja, Struktur oft verloren |
| Foto oder Scan | problematisch | KI muss erst „lesen“, häufig mit Fehlern und Lücken. |
Bei Spalten, Tabellen und Fußnoten gerät die Lesereihenfolge durcheinander. Das wirkt sich oft stärker aus als das Problem mit der Mitte. Große Dateien werden außerdem nicht vollständig gelesen: Das System sucht nur die Ausschnitte heraus, die zur Frage passen (Fachbegriff: RAG).
Deshalb am besten den Text aus dem Dokument kopieren und direkt in den Chat einfügen. Ein PDF als Datei hochladen, nie als Foto. Für lange Dokumente eignet sich NotebookLM von Google besser, mehr dazu im Beitrag KI als Tutor einrichten.
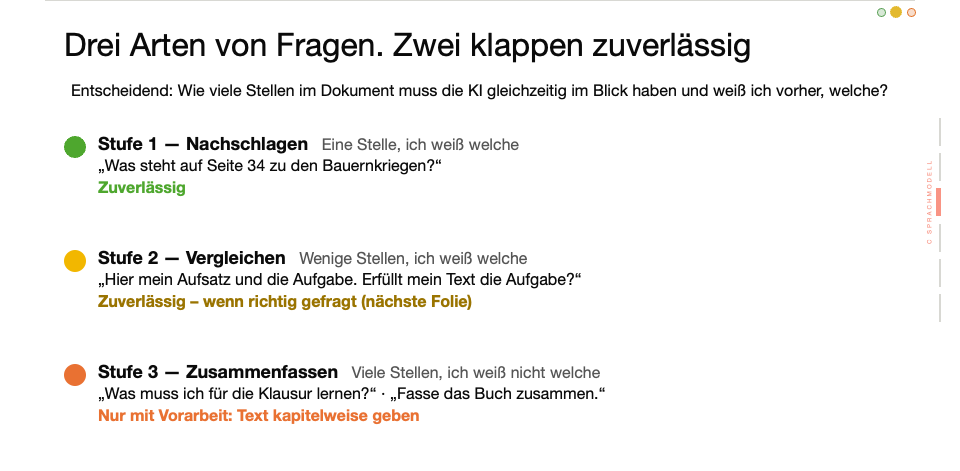
Drei Arten von Fragen, zwei klappen zuverlässig
Wichtiger als die Seitenzahl ist die Art der Frage. Ein einfacher Test hilft: Weiß ich vorher, wo im Dokument die Antwort steht? Und wie viele Stellen muss KI gleichzeitig im Blick haben?
So lässt man einen Aufsatz richtig prüfen
Der häufigste Fehler zu Hause: Das Kind fügt seinen Aufsatz ein und fragt „Ist das gut?“, ohne Aufgabe und ohne Kriterien. Der Aufsatz ist lang, die Aufgabe dagegen nur ein Satz oder fehlt ganz.
Also urteilt KI nach dem Stil (grosser Anteil), nicht nach dem Auftrag (keiner Anteil), rät, was gemeint sein könnte, und antwortet mit „Super gemacht“. Die Neigung zum Loben verstärkt das noch (siehe Der Ja-Sager-Effekt).
Nicht so
- Aufsatz einfügen und fragen: „Erfüllt mein Text die Aufgabe?“
- Aufgabe und Kriterien weglassen.
- Ein pauschales „Ja, gut gemacht“ akzeptieren.
Sondern so
- Reihenfolge einhalten: erst die Aufgabe, dann die Kriterien, zuletzt der Aufsatz.
- Kriterien benennen: bei einer Erörterung zum Beispiel These, je zwei Pro- und Contra-Argumente mit Begründung, Fazit.
- Klaren Auftrag geben: „Gehe die Kriterien einzeln durch. Zitiere zu jedem die Stelle, die es erfüllt, oder schreibe ‚fehlt‘.“
-> Auch die Reihenfolge wirkt sich aus: Steht die Aufgabe vorn und der Aufsatz hinten, urteilt KI strenger als umgekehrt.
Quellen
- Liu, Lin, Hewitt, Paranjape, Bevilacqua, Petroni, Liang: Lost in the Middle: How Language Models Use Long Contexts, Transactions of the Association for Computational Linguistics 12 (2024), S. 157–173, aclanthology.org/2024.tacl-1.9
- Hong, Troynikov, Huber: Context Rot: How Increasing Input Tokens Impacts LLM Performance, Chroma Technical Report, 14. Juli 2025 (nicht begutachtet), trychroma.com/research/context-rot
