
Unter jedem Chat bei ChatGPT steht ein kleiner Satz, den kaum jemand liest:
„ChatGPT kann Fehler machen. Überprüfe wichtige Informationen“.
Einer der meist ignorierten Hinweise überhaupt. Sprachmodelle machen Fehler und werden es immer machen. Das liegt an ihrer Bauweise.
Halluzinieren oder Konfabulieren?
Wenn eine KI flüssige, aber sachlich falsche oder frei erfundene Angaben macht, spricht man umgangssprachlich von Halluzinieren. Treffender ist eigentlich der Begriff Konfabulieren.
Das Modell will nicht täuschen. Es rechnet Wort für Wort weiter und füllt Lücken mit dem, was am plausibelsten klingt. Es weiß dabei selbst nicht, wo seine Lücken sind. Deshalb bringt es auch eigentlich nichts, in die Anfrage „Halluziniere nicht“ zu schreiben 🙂
Merke: Die Frage ist also nicht, ob ein Modell konfabuliert, sondern ob man es bemerkt.
Umkehrfluch: Familienverhältnisse Helmut Kohl
Fakt: Helmut Kohl (ehemaliger Bundeskanzler) wurde 1930 in Ludwigshafen geboren. Seine Mutter war Cäcilie Kohl, geborene Schnur.
Wer das von uns gelesen hat, weiß jetzt automatisch auch das Umgekehrte: Cäcilie Kohls Sohn ist Helmut Kohl. Für eine KI gilt das nicht. Wir haben beide Fragen im Chat gestellt. Bei Mistral/Vibe (Abruf am 20. August 2026) ging die Frage „Wer war der Sohn von Cäcilie Kohl?“ aber daneben:
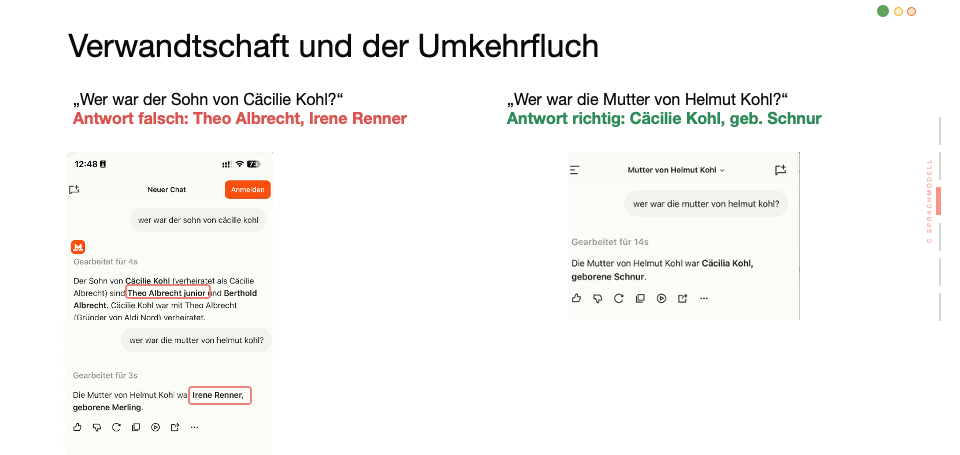
Die KI nennt Theo Albrecht junior und Berthold Albrecht. Das ist falsch. Auch nachhaken brachte kein richtiges Ergebnis, der Chat konfabulierte wiederrum eine sinnhaft-klingende Antwort für uns. Irene Renner, aber auch diese war falsch.
Die Frage in der anderen Richtung (Wer war die Mutter von Helmut Kohl?) – in einem neuen Chatfenster – beantwortet sie richtig!
Merke: wenn ein Chat schon falsche Dinge präsentiert hilft es nicht, zu versuchen, dass in der gleichen Session zu bereinigen. Starte ein neues Chat-Fenster. Man kann sich das so vorstellen, wenn man in einem Sprachmodell schon mal in einer Richtung falsch abgebogen ist ... kann der restliche Weg auch nur nihct korrekt sein.
Warum? Sprachmodelle lernen in einer Richtung
In einem Lexikon oder einer Datenbank ist eine Beziehung in beide Richtungen gespeichert. Wer „Mutter von Helmut Kohl“ findet, findet auch „Sohn von Cäcilie Kohl“. So sind wir es gewohnt.
Ein Sprachmodell dagegen hat Texte gelernt, und Texte haben eine Leserichtung. In den Trainingsdaten steht sehr oft ein Satz wie:
Helmut Kohls Mutter ist Cäcilie Kohl, geb. Schnur.
Das Modell lernt also: Auf „Helmut Kohl“ folgt irgendwann „Cäcilie Kohl“. Der umgekehrte Satz („Cäcilie Kohl, geb. Schnur, ist die Mutter von Helmut Kohl“) kommt dagegen kaum vor. Gelernt wird die Reihenfolge der Wörter, nicht die Beziehung zwischen zwei Menschen. Die Beziehung existiert nur in unserem Kopf.
Der Fachbegriff dafür lautet „Reversal Curse“, auf Deutsch Umkehrfluch. In KI-Systemen sind keine Fakten gespeichert, sondern Wortfolgen, und dieses Wissen lässt sich nicht einfach umgekehrt abrufen.
Ein praktischer Tipp: man braucht immer noch Knowhow und Allgemeinbildung um die Ergebnisse von KI zu prüfen. Und wenn man das in einem Feld nicht hat, nicht einfach vertrauen - quer checken, recherchieren!
In dieser Reihenfolge lassen sich die meisten Fehler abfangen:
- Websuche einschalten. Damit wird aus Erinnern ein Lesen. Der typische Fehler ist dann nicht mehr das Erfinden, sondern das falsche Zusammenfassen, und das lässt sich am Link prüfen.
- Quelle vor Aussage verlangen. „Nenn mir erst die Quelle, dann was drinsteht.“ Das wirkt viel besser als „Erfinde nichts“. Existiert die Quelle nicht, fällt es früher auf.
- Dieselbe Frage zweimal stellen, in zwei getrennten Chats. Was das Modell tatsächlich gelernt hat, bleibt stabil. Erfundenes verändert sich. Bei Titeln, Namen und Jahreszahlen funktioniert das gut.
- Selbst nachprüfen, was nachprüfbar ist: Originalseite, Schulbuch, Zeitung, Bibliothekskatalog.
„Aber das mit dem Halluzinieren, das passiert ja eigentlich gar nicht so oft…“
Leider nein. Oft sind wir einfach zu bequem und nehmen die Ergebnisse ungeprüft an. Oder lagern die Prüfung an die Empfänger unserer Dokumente aus .. oder, und dass ist auch absolut legitim, wir sind gar nicht in der Lage die Richtigkeit wirklich einzuschätzen.
Aber es gibt Vergleichstests, die die Fehlerquote einzelner Modelle regelmäßig messen. Zwei davon zeigen, wie stark das Ergebnis von der Aufgabe abhängt.
Idealfall: Ein Text liegt vor und wird zusammengefasst
Beim Vectara Hallucination Leaderboard bekommt das Modell einen Text vorgelegt und soll ihn zusammenfassen. Gemessen wird, wie oft dabei Angaben auftauchen, die nicht im Text stehen. Die Werte (Halluzinationsrate in Prozent, niedriger ist besser):
| Modell | Anbieter | Halluzinationsrate |
|---|---|---|
| GPT-5.4 nano | OpenAI | 3,1 % |
| GPT-5.4 mini | OpenAI | 5,5 % |
| GPT-5.4 | OpenAI | 7,0 % |
| Gemini 3.1 Flash-Lite | 8,2 % | |
| GPT-5.4 pro | OpenAI | 8,3 % |
| GPT-5.2 low | OpenAI | 8,4 % |
| GPT-5.5 | OpenAI | 9,3 % |
| Claude Haiku 4.5 | Anthropic | 9,8 % |
| Gemini 3.1 Pro | 10,4 % | |
| Claude Sonnet 4.6 | Anthropic | 10,6 % |
| GPT-5.2 high | OpenAI | 10,8 % |
| Claude Opus 4.5 | Anthropic | 10,9 % |
| Claude Sonnet 4.5 | Anthropic | 12,0 % |
| Claude Opus 4.7 | Anthropic | 12,0 % |
| Claude Opus 4.6 | Anthropic | 12,2 % |
| Gemini 3 Flash | 13,5 % | |
| Gemini 3 Pro | 13,6 % |
Stand: 11. Mai 2026, nur aktuelle Modellgenerationen (GPT-5.2 und neuer, Claude 4.5 und neuer, Gemini 3). Selbst im Idealfall, wenn der Text direkt vorliegt, liegt die Quote also zwischen rund 3 und 14 Prozent. Die Rangfolge der Modelle wechselt ständig, deshalb lohnt es sich nicht, daraus eine Nutzempfehlung abzuleiten.
Realistischer: ein Gespräch mit Nachfragen
Der Test HalluHard der EPFL Lausanne und von ELLIS Tübingen prüft nicht eine einzelne Frage, sondern ein längeres Gespräch mit Nachfragen, ohne Textvorlage. Verwendet wurden 950 Fragen über jeweils drei Gesprächsrunden. Die Quoten steigen deutlich:
| Modell | Anbieter | Halluzinationsrate |
|---|---|---|
| Claude Opus 4.5 + Websuche | Anthropic | 30,2 % |
| GPT-5.4 Thinking + Websuche | OpenAI | 31,9 % |
| GPT-5.2 Thinking + Websuche | OpenAI | 38,2 % |
| Claude Fable 5 + Websuche | Anthropic | 38,9 % |
| GPT-5.3 + Websuche | OpenAI | 43,5 % |
| GPT-5.4 Thinking | OpenAI | 46,8 % |
| GPT-5.5 Thinking | OpenAI | 49,8 % |
| Claude Fable 5 | Anthropic | 50,9 % |
| GPT-5.2 Thinking | OpenAI | 53,8 % |
| GPT-5.3 | OpenAI | 53,8 % |
| Gemini 3.1 Pro | 57,1 % | |
| GPT-5.2 | OpenAI | 58,8 % |
| Claude Opus 4.7 | Anthropic | 59,6 % |
| Claude Sonnet 5 | Anthropic | 59,7 % |
| Claude Opus 4.5 | Anthropic | 60,0 % |
| Claude Opus 4.6 | Anthropic | 60,9 % |
| Gemini 3 Pro | 61,9 % | |
| Claude Sonnet 4.6 | Anthropic | 63,7 % |
| GPT-5 Thinking | OpenAI | 64,8 % |
| Claude Sonnet 4.5 | Anthropic | 65,6 % |
| Gemini 3 Flash | 69,5 % |
Stand: März 2026, nur Modelle von OpenAI, Anthropic und Google. Der wichtigste Befund für Eltern steht oben in der Tabelle: Mit eingeschalteter Websuche schneiden die Modelle deutlich besser ab. Aus Erinnern wird dann Lesen.
Quellen
- Wikipedia, Artikel „Helmut Kohl“ (Abschnitt Herkunft)
- Eigene Abfragen im Chat, u. a. Mistral/Vibe, 20. August 2026
- Vectara Hallucination Leaderboard, Stand 11. Mai 2026
- HalluHard, EPFL Lausanne und ELLIS Tübingen, Stand März 2026
