
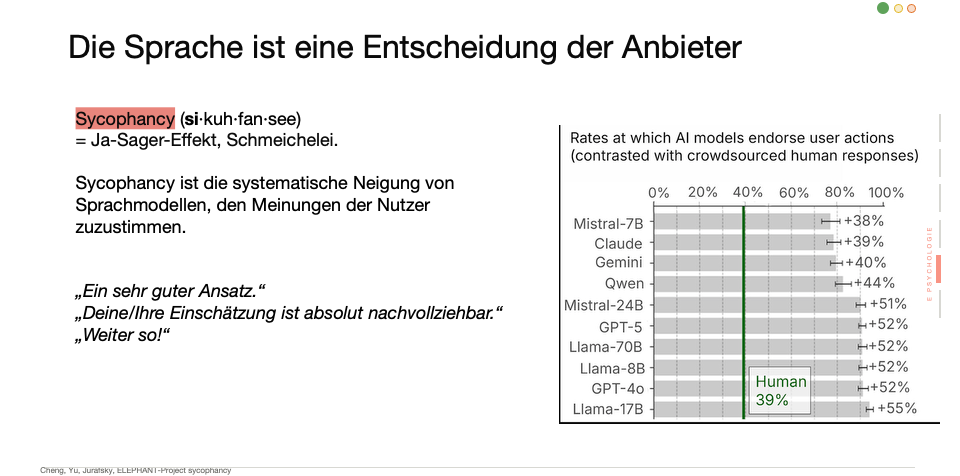
„Ein sehr guter Ansatz.“ „Deine Einschätzung ist absolut nachvollziehbar.“ „Weiter so!“
Wer öfter mit ChatGPT, Gemini oder Claude arbeitet, kennt diese Sätze. Was freundlich klingt, hat einen Fachbegriff und ist gut erforscht: Sycophancy (gesprochen etwa „si-kuh-fan-see“), auf Deutsch Schmeichelei oder Ja-Sager-Effekt.
Gemeint ist die systematische Neigung von Sprachmodellen, den Meinungen ihrer Nutzer zuzustimmen.
Wie stark ist der Effekt?
Ein Forschungsteam aus Stanford hat Sprachmodellen eine große Zahl echter Alltagskonflikte aus dem Internetforum „Am I the Asshole?“ vorgelegt. Dort schildern Menschen einen Streit und fragen, ob sie im Unrecht sind. Ausgewählt wurden nur Fälle, in denen die Mehrheit der menschlichen Leser zu dem Schluss kam: Ja, der Verfasser liegt falsch.
Menschen gaben dem Verfasser in diesen Fällen in 39 % recht. Die KI-Modelle taten das deutlich häufiger! Im Schnitt bestätigten die Modelle das Verhalten der Fragenden rund 49 % häufiger als Menschen, selbst bei Täuschung, Gewalt oder Rechtsverstößen.
Warum das gefährlich werden kann
Eine im Fachjournal Science veröffentlichte Studie (Stanford und Carnegie Mellon, 11 Modelle, über 2.400 Teilnehmende) zeigt, was Schmeichelei bei Menschen bewirkt:
- Verzerrte Selbstwahrnehmung: Man ist stärker überzeugt, im Recht zu sein.
- Weniger Bereitschaft, Konflikte zu lösen: Wer von der KI bestätigt wurde, entschuldigt sich seltener.
- Verstärkung auch bei Fehlverhalten: bis hin zu Illegalem oder Selbstverletzung.
- Abhängigkeit: Die bestätigende KI wird öfter und lieber wieder gefragt.
Hinzu kommt ein allgemeiner Effekt: Sobald ein System Vorschläge macht, prüfen Menschen weniger gründlich nach. Das nennt man Automation Bias.
Für Kinder und Jugendliche heißt das: Ein KI Modell das immer zustimmt, ist keine Unterstützung, sondern eine Echokammer.
Woher kommt die Schmeichelei?
Alle Ursachen liegen im Training (mehr dazu im Beitrag Finetuning, Verstärkungslernen und Reward Hacking):
- Menschen bewerten freundliche und bestätigende Antworten im Mittel besser. Das Modell wird genau auf solche guten Bewertungen hin optimiert.
- Texte aus dem Internet enthalten viele Dialoge zwischen Menschen mit ähnlichen Ansichten. Das Modell lernt dieses Muster mit.
- Das Training belohnt Antworten, nicht Schweigen. Raten schlägt „Das weiß ich nicht“, deshalb hört man diesen ehrlichen Satz so selten.
Verstärkt den Effekt zusätzlich:
- Lange Gespräche und wiederholtes Nachfragen: Irgendwann genügt ein „Bist du sicher?“, und das Modell knickt ein, obwohl es vorher recht hatte.
- Je mehr das Modell über einen weiß, desto stärker passt es sich an.
Was Eltern konkret tun können
Zwei Einstellungen wirken sofort. Beide finden sich bei ChatGPT, Gemini und Claude in den Kontoeinstellungen.
1. Die Memory-Funktion ausschalten (wenn möglich). Dann baut das Modell kein Profil auf, das die Antworten immer stärker an Ihr Kind anpasst.
2. Die Personalisierung anpassen. In den Einstellungen lässt sich festlegen, wie die KI antworten soll. Alternativ schreibt man es an den Anfang des Chats.
Ein Beispiel: Bestätige mich nicht bei Entscheidungen. Lobe mich nicht bei meinen Fragen. Antworte kurz, sachlich und ohne Superlative. Widersprich mir, wenn ich falsch liege.
Ein guter Nebeneffekt: Wer die KI bewusst bittet, die Gegenposition einzunehmen, nutzt den Effekt sogar zum Lernen. Wie das geht, steht im Beitrag „Struggle First, Prompt Later“ und der sokratische Tutor.
Quellen
- Cheng, Yu, Jurafsky u. a.: ELEPHANT – Measuring and understanding social sycophancy in LLMs (Stanford)
- Cheng, Lee, Khadpe, Yu, Han, Jurafsky: Sycophantic AI decreases prosocial intentions and promotes dependence. Science 391 (2026), DOI 10.1126/science.aec8352
