
Wer mit Kindern über KI sprechen will, sollte ungefähr wissen, was in so einem System passiert. Keine Sorge: Es geht hier um das Prinzip, nicht um Mathematik. Alles, was folgt, ist bewusst vereinfacht.
Schauen wir uns an einer ganz einfachen Frage an, was passiert wenn wir von einem KI Modell eine Antwort bekommen:
Frage: Was macht die Katze mit der Maus?
Antwort: Die Katze jagt die Maus, da sie Hunger hat.
Schritt 1: Der Text wird in Token zerlegt
Bevor die KI irgendetwas rechnen kann, zerlegt sie den Text in Stücke, sogenannte Token. Häufige Wörter sind ein einziges Token, seltene Wörter zerfallen in mehrere. Jedes Token bekommt eine Nummer, und nur mit diesen Nummern arbeitet das Modell.
| Token | Nummer |
|---|---|
| Was | 27125 |
| ·macht | 53649 |
| ·die | 2815 |
| ·Kat | 17816 |
| ze | 3059 |
| ·mit | 5568 |
| ·der | 2761 |
| ·Ma | 11583 |
| us | 355 |
| ? | 30 |
Die KI sieht also keine Wörter und keine Bedeutung, sondern Zahlen. Deutsch braucht dabei je nach Modell rund 20 bis 50 % mehr Token als Englisch. Wie viele Token ein Modell auf einmal verarbeiten kann, bestimmt sein Kontextfenster. Dazu mehr im Beitrag Warum KI im langen Chat vergisst.
Selbst ausprobieren: behind-ai.ch/tokenization
Schritt 2: Bedeutung wird zu Nähe
Jedes Token bekommt einen Platz in einem riesigen „Bedeutungsraum“ (Fachbegriff: Embedding). Wörter, die in ähnlichen Zusammenhängen vorkommen, liegen dort nah beieinander. Ganz schematisch: „Katze“ liegt in der Nähe von „Maus“, aber weit weg von „Frischkäsezubereitung“.
Diese Positionen hat niemand festgelegt. Sie entstehen im Training aus großen Textmengen und sind für Menschen oft nicht nachvollziehbar. Das ist die sogenannte Blackbox von der die KI Hersteller immer sprechen.
Selbst ausprobieren: behind-ai.ch
Schritt 3: Gewichtung, also was gehört zusammen?
Jetzt berechnet das Modell für jedes Token, welche anderen Token gerade wichtig für es sind. In unserer Frage wird „macht“ stark mit „Katze“ verbunden und „mit“ mit „Maus“. So ergibt sich, dass die Katze etwas tut und die Maus betroffen ist, nicht umgekehrt.
Der Platz im Bedeutungsraum ist fest. Die Verbindungen dazwischen werden aber bei jeder Frage neu berechnet, manche werden stark, andere bleiben schwach.
Dieses Verfahren heißt Attention und wurde 2017 in dem Forschungspapier „Attention Is All You Need“ vorgestellt.
Schritt 4: Aus Mustern wird ein Vorschlag
Im Training hat das Modell sehr viele Texte „gelesen“. Dabei hat sich in seinen Gewichten ein Muster festgesetzt: Katze trifft Maus, ein Grund wird gesucht, und typische Fortsetzungen sind Hunger, fressen oder spielen.
Gespeichert sind dabei keine Fakten über Katzen, sondern Muster. Das Modell weiß nichts über Katzen. Kann nciht begreifen, was eine Katze ist. Es hat nur sehr oft gelesen, was über Katzen (von Menschen .. und von KI ;-)) geschrieben wird.
Schritt 5: Die Antwort entsteht Wort für Wort
An jeder Stelle der Antwort erstellt das Modell eine Liste möglicher nächster Wörter mit Wahrscheinlichkeiten und wählt meist das wahrscheinlichste. Schematisch sieht das so aus:
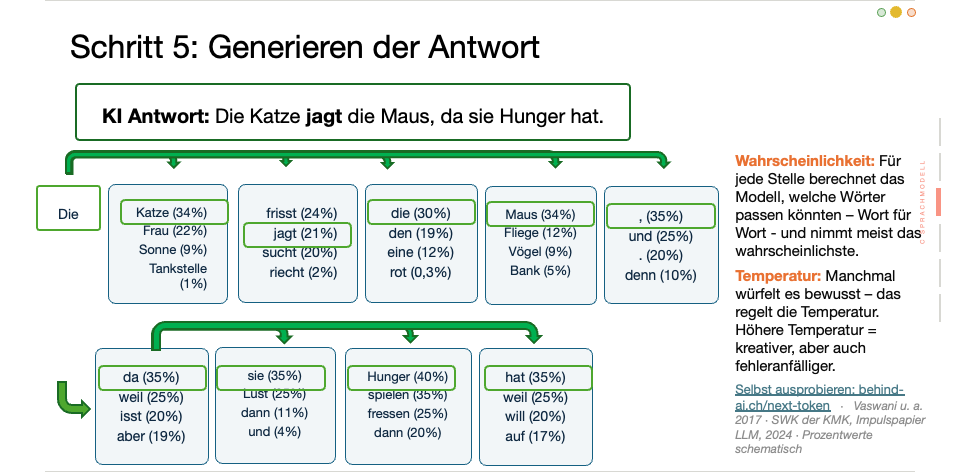
Beim zweiten Wort hat das Modell nicht das wahrscheinlichste genommen („frisst“), sondern „jagt“. Das ist Absicht: Ein Regler namens Temperatur sorgt dafür, dass das Modell manchmal bewusst würfelt. Eine höhere Temperatur macht die Antworten abwechslungsreicher, aber auch fehleranfälliger.
Selbst ausprobieren: behind-ai.ch/next-token
Was man sich merken sollte: Die KI hat 0% Verständnis vom Inhalt. Sie berechnet nur, was als nächstes Wort (bzw. nächster Token) wahrscheinlich kommt und stellt dieses dar.
Quellen
- Vaswani u. a.: Attention Is All You Need, NeurIPS 2017
- Ständige Wissenschaftliche Kommission der KMK: Impulspapier Large Language Models, 2024
- Petrov u. a.: Language Model Tokenizers Introduce Unfairness Between Languages, NeurIPS 2023
- Interaktive Demos: behind-ai.ch
