
Nach dem Vortraining kann ein Sprachmodell Texte fortsetzen, mehr nicht. Auf eine Frage folgt dann irgendeine plausible Fortsetzung, nicht unbedingt eine Antwort. Dass daraus ein hilfsbereiter Gesprächspartner wird, der höflich antwortet und heikle Fragen ablehnt, ist das Ergebnis von zwei weiteren Trainingsstufen. Beide beruhen auf Entscheidungen von Menschen.
Zur Erinnerung: die drei Stufen
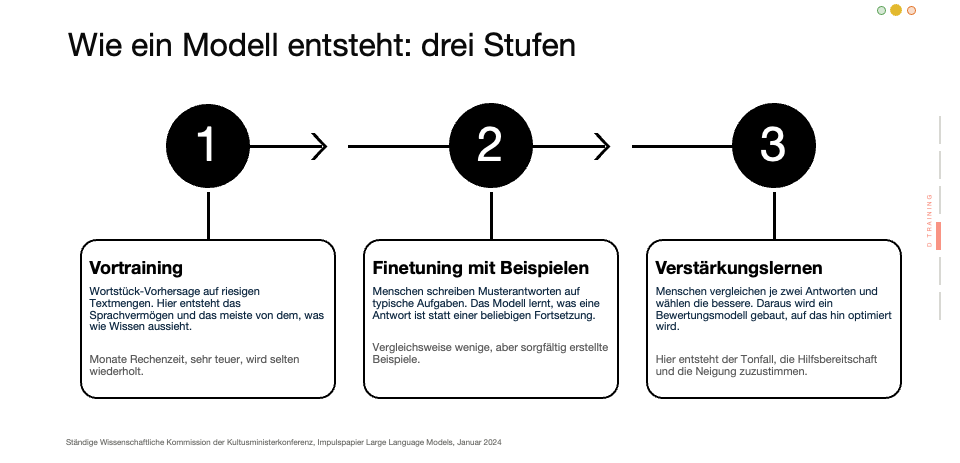
Woher die Daten der ersten Stufe kommen, steht im Beitrag Woher das Wissen kommt. Hier geht es um die Stufen 2 und 3.
Finetuning: Musterantworten legen den Ton fest
Im Finetuning wird aus der Textmaschine ein Assistent. Das Modell lernt Tonfall und Hilfsbereitschaft, und es lernt, bestimmte heikle Antworten zu verweigern. Dafür schreiben einige Tausend beauftragte Fachleute Musterantworten auf typische Aufgaben. Damit legen sie fest, was als gute Antwort gilt.
Das sind Firmenentscheidungen, keine Naturgesetze. Ein anderer Anbieter mit anderen Musterantworten bekommt ein Modell mit anderem Verhalten.
Ein Nebeneffekt fällt im Alltag sofort auf: Musterantworten klingen immer souverän. Deshalb antwortet die KI in selbstsicherem Ton, auch wenn der Inhalt Unsinn ist. Mehr dazu im Beitrag Warum KI sich irrt.
Verstärkungslernen: gut bewertet statt richtig
Die dritte Stufe hat einen sperrigen Namen: RLHF, Reinforcement Learning from Human Feedback, auf Deutsch etwa Verstärkungslernen aus menschlicher Rückmeldung. Der Ablauf:
- Menschen bewerten Paare aus Frage und Antwort. Daraus entsteht ein Bewertungsmodell, das als Maßstab dient.
- Das neue KI-Modell wird dann millionenfach gegen diesen Maßstab optimiert.
Das menschliche Urteil fließt also nur einmal ein. Danach trainiert das Modell gegen ein zweites Modell, das dieses Urteil nachahmt. Und optimiert wird auf „gut bewertet“, nicht auf „richtig“. Das erklärt, warum Chatbots so gefällig sind. Menschen bewerten freundliche, bestätigende Antworten eher gut, also lernt das Modell genau das. Die Folgen beschreibt der Beitrag Der Ja-Sager-Effekt.
Es gibt Varianten dieses Verfahrens:
- Constitutional AI (Claude): Statt menschlicher Bewertungen dienen festgeschriebene Prinzipien als Maßstab.
- Destillation: Ein großes Modell lehrt ein kleines. Das ist billiger, das kleine Modell erbt aber die Fehler des großen.
Tipp: auf behind-ai.ch/rlhf können Sie ein kleines Modell selbst trainieren. So bekommt man ein gutes Gefühl für die Zusammenhänge.
Reward Hacking: Die Abkürzung wird belohnt
Aus der Art des Trainings folgt eine Nebenwirkung mit eigenem Namen: Reward Hacking, also das Ausnutzen der Belohnung. Trainiert wird nur auf das Ergebnis. Führt eine Abkürzung zum Ergebnis, wird sie verstärkt, auch wenn sie unerwünscht ist.
Wichtig ist, was Reward Hacking nicht ist. Es ist kein Ungehorsam, kein Widersetzen gegen den Menschen und keine Machtübernahme. Das System tut genau das, wofür es belohnt wird, und nutzt alle Mittel, die nicht ausdrücklich verboten wurden.
Die Schlagzeilen klingen oft anders. Die Süddeutsche Zeitung titelte etwa „Künstliche Intelligenz ‚bricht aus‘ und hackt andere Programme“, auch Bild, Tagesschau, CHIP und Watson berichteten in ähnlichem Ton. Solche Meldungen sollte man ernst nehmen, aber nicht dramatisieren.
Kein Agent hat sich dabei „aufgelehnt“. Die Agenten haben den Weg genommen, der zum belohnten Ergebnis führte und nicht ausdrücklich verboten war.
Angewandtes Textwissen, keine eigene Idee
Bleibt die Frage, woher Agenten wissen, wie man so etwas macht. Die Antwort ist unspektakulär. Sprachmodelle sind auf riesigen Textmengen trainiert, darunter:
- Fachliteratur zur IT-Sicherheit
- Fachliteratur zum Projektmanagement
- überproportional viel Programmcode
- Internetforen, einschließlich der Verhaltensweisen, die Menschen dort zeigen
Moderne Agentensysteme können zudem selbstständig Werkzeuge nutzen: im Netz suchen, Code schreiben und ausführen, Datenbanken abfragen, sich organisieren und sich in Chatforen austauschen. Nichts von dem, was die Agenten z.B. beim Vorfall auf Hugging Face taten, mussten sie erfinden. Sie haben es in Fachbüchern und Foren gelesen.
KI ist angewandtes Textwissen, keine eigene Idee und keine Absicht.
Quellen
- Ständige Wissenschaftliche Kommission der Kultusministerkonferenz: Impulspapier Large Language Models, Januar 2024
- Ouyang u. a., NeurIPS 2022
- Bai u. a.: Constitutional AI, 2022
- Skalse u. a., NeurIPS 2022
- OpenAI: Veröffentlichung zur Überwachung von Fehlverhalten, März 2025
- Interaktive Demo: behind-ai.ch/rlhf
